
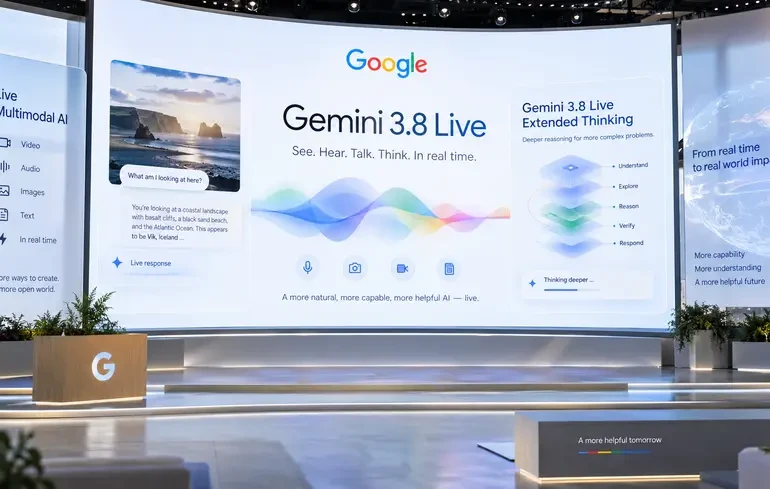
Google представила дві нові голосові моделі Gemini, які мають зробити спілкування зі штучним інтелектом швидшим і природнішим. Старша версія Gemini 3.8 Live Extended Thinking здатна паралельно вести діалог і виконувати складні багатокрокові завдання.
Компанія випустила Gemini 3.8 Live і Gemini 3.8 Live Extended Thinking. Обидві моделі орієнтовані насамперед на голосове спілкування в реальному часі, але відрізняються рівнем складності завдань, які можуть виконувати.
Gemini 3.8 Live створили як швидшу й економнішу модель для масштабного використання. Вона підтримує природний діалог, працює з візуальним контекстом і може використовувати інструменти та API під час розмови.
Gemini 3.8 Live Extended Thinking призначена для складніших сценаріїв. Вона отримала розширене багатокрокове міркування й може виконувати тривалі завдання, не припиняючи розмову з користувачем.
Одна з ключових можливостей старшої моделі — здатність одночасно аналізувати запит і підтримувати голосовий діалог. Під час складної операції система може коротко відповідати користувачеві, а паралельно продовжувати роботу.
Google також заявляє, що нові моделі краще підходять для голосових агентів у корпоративних сервісах. Їх планують використовувати в Gemini, Google Workspace і пошуку, а розробникам вони доступні через Gemini Live API.
Gemini 3.8 Live може аналізувати зображення та інший візуальний контент майже в реальному часі. Крім того, модель автоматично розпізнає та перемикається між 97 мовами без необхідності переривати діалог.
Ще одна функція дає змогу запускати зовнішні інструменти й API у фоновому режимі. Поки система виконує запит, користувач може продовжувати розмову.
Gemini 3.8 Live Extended Thinking показала 82,6 бала в Artificial Analysis Speech to Speech Quality Index. У тесті τ-Voice на агентські завдання модель набрала 68,6%, у банківському тесті Sierra τ-Voice — 35,1%, а в Big Bench Audio — 97,7%.
Молодша Gemini 3.8 Live посіла друге місце в Speech Agent Arena. Google окремо наголошує на її нижчій вартості та придатності для великої кількості одночасних голосових взаємодій.
У тесті EVA-Bench від ServiceNow обидві моделі вийшли на так звану межу Парето — баланс між точністю виконання складних завдань і якістю діалогу.
Нові моделі вже інтегрують платформи Agora, Fishjam, LangChain, LiveKit, Pipecat, Vercel і Vision Agents. Вони надають інфраструктуру для потокової передачі аудіо та відео, щоб розробники могли зосередитися на логіці голосових сервісів.
Google також співпрацює з Salesforce, Genspark і Lumeris. За даними компанії, партнери позитивно оцінюють швидкість відповіді, плавність діалогу та можливості виклику зовнішніх інструментів.
🌟 Читайте «Експерт» у своєму смартфоні — додайте нас в Google Discover